

记一次 OCI Boot Volume 离线修复记录。本文依据实际操作记录整理,未验证的原因不作确定结论。
一、一次 DD 重装,实例却失联了
这台 OCI 实例原本运行的是 Ubuntu 24.04.1 LTS。此前我在这类环境中使用 DD 方式安装过 Debian 10、Debian 11,过程都比较顺利。这一次尝试安装 Debian 12,执行 DD 后,实例却无法正常连接。
起初很容易把问题归结为系统已经被覆盖,甚至考虑再次 DD。但如果直接重装,原系统中可能仍然存在的可用数据和启动环境也会一并失去。因此,我决定先把原 Boot Volume 分离出来,通过另一台救援 VPS 检查磁盘,再决定下一步。
二、把原 Boot Volume 挂载到救援 VPS
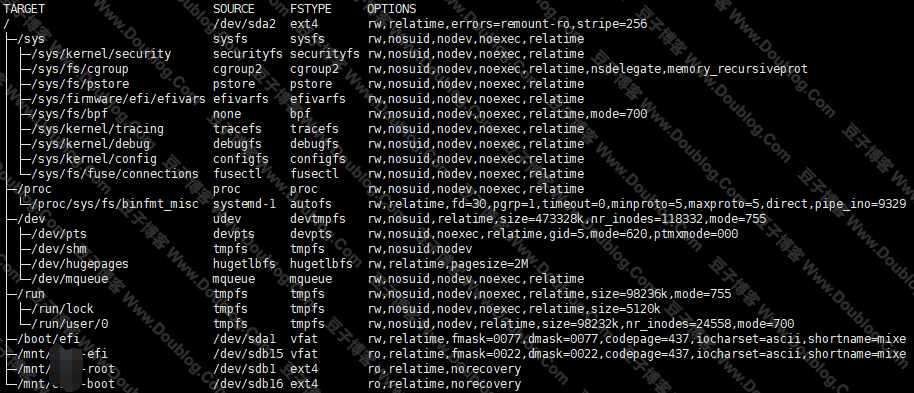
救援环境是一台 Debian 11 AMD64 VPS。原实例的 Boot Volume 作为附加卷连接后,设备识别为 /dev/sdb;救援 VPS 自己的系统盘则是 /dev/sda。这两个设备必须严格区分,不能因为设备名称相似就对错误磁盘执行写入操作。
我先通过分区、文件系统和 UUID 信息确认原盘布局,再以只读方式检查 Ubuntu 根分区、BOOT 分区和 EFI 分区。检查结果显示,原 Ubuntu 根分区仍然存在,EFI 分区和 BOOT 分区也都能够识别。
三、问题线索出现在 GRUB 启动配置中
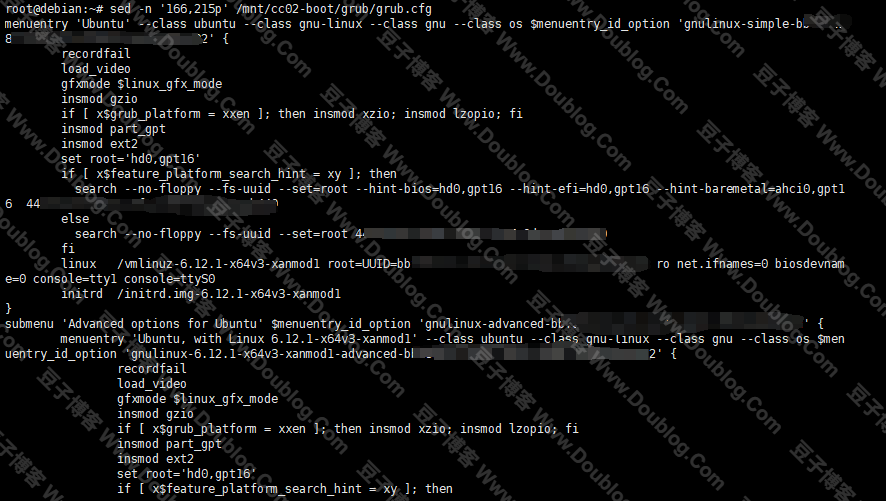
继续检查 BOOT 分区中的 GRUB 配置后,发现默认启动项已经指向 Debian 安装器,而不是原来的 Ubuntu 启动项。同时,GRUB 环境变量中存在 recordfail=1,对应分支的等待时间被设置为 0。
这意味着机器在启动时可能直接选择了错误的启动入口,并且没有留下可供人工干预的等待时间。EFI 固件本身仍然保留 Ubuntu 启动入口,EFI 配置指向的 BOOT 分区 UUID 也与实际分区一致。
四、检查内核和 initrd,确认原系统还保留着可用启动文件
我没有仅凭文件存在就判断内核可用,而是进一步对照包管理器记录进行校验。6.12 XanMod 内核映像的 MD5 与 dpkg 清单中的记录一致;对应 initrd 的 Zstandard 完整性检查和 CPIO 内容检查也通过,里面还能找到虚拟磁盘、网络等相关驱动模块。
与此同时,另一个 6.8 内核映像的 MD5 与原 dpkg 清单不一致。这说明 DD 过程可能改写过原系统的部分文件,但仅凭这一项异常,无法推断整个系统被覆盖到什么程度,也不能据此认定 Debian 12 镜像本身存在缺陷。
五、修正 GRUB 默认启动项
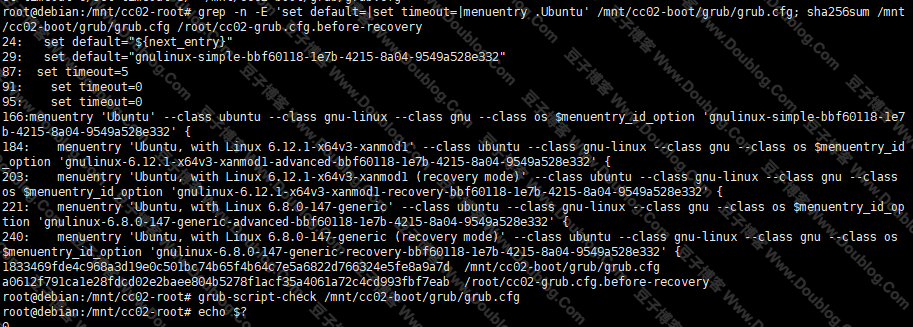
在确认目标配置和原始文件备份后,我将 GRUB 默认启动项调整为原 Ubuntu 的主菜单 ID,并把 recordfail 分支的等待时间调整为 5 秒。修改前保留了配置备份,修改后使用 grub-script-check 检查语法,退出码为 0。
这里需要说明:配置文件中其他条件分支仍然存在 set timeout=0,它们并不是本次修改的目标;不能只看到文件里还有 timeout=0,就认为 recordfail 分支没有修复。
六、安全卸载磁盘并重新关联 Boot Volume
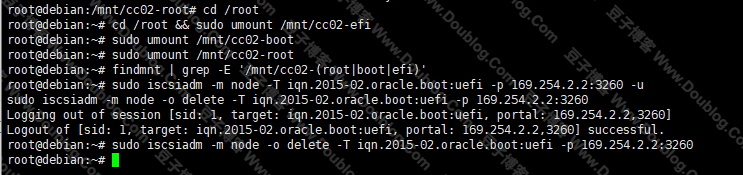
完成修改和检查后,我将 BOOT 分区恢复为只读,依次卸载 EFI、BOOT 和根分区,再通过 OCI 环境对应的 iSCSI 命令断开附加卷连接。命令返回 Logout successful,随后删除对应节点记录。
确认救援 VPS 不再使用该卷后,我把原 Boot Volume 重新关联到 CC-02 实例并启动。
七、Ubuntu 重新启动,网络和探针恢复
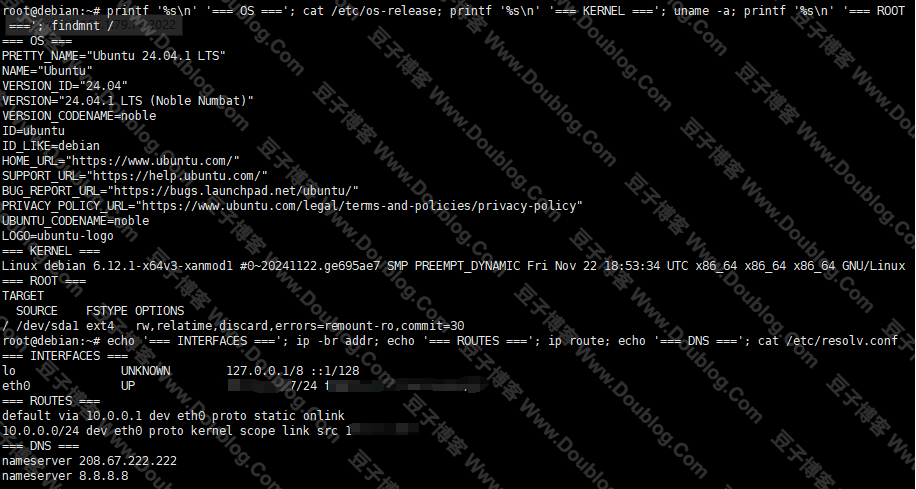
重新启动后,实例成功进入原来的 Ubuntu 24.04.1 LTS,运行内核为 6.12.1-x64v3-xanmod1。根分区以读写方式挂载,网络接口 eth0 正常取得内网地址,默认路由和 DNS 配置也恢复正常。随后,哪吒探针重新上线。
至此,原系统恢复启动。本次没有再次对 Boot Volume 执行整盘 DD,也没有重装 Ubuntu。
八、这次故障带来的几点经验
- DD 命令执行完成,不等于目标系统一定能够正常启动。写盘结果和启动链是否正确,是两个不同层面的问题。
- 遇到实例失联,不要急着再次 DD。先确认 EFI、GRUB、内核、initrd 和根分区是否仍然存在,可能会找到保留原系统的机会。
- 离线检查附加磁盘时,必须明确区分救援 VPS 的系统盘和待修复磁盘;能只读检查的步骤,优先只读。
- 修改启动配置前先备份,修改后进行语法检查,并记录文件校验值,确保过程可追溯。
- 以前在相同云环境中成功使用 Debian 10、Debian 11 的 DD 方式,并不能证明 Debian 12 的镜像、脚本和启动流程完全相同。本次经历值得进一步调查,但还不足以断言 Debian 12 本身有缺陷。
结语
这次故障最后没有靠再次 DD 解决,而是通过离线检查找到了 GRUB 默认启动项的问题,让原来的 Ubuntu 重新启动起来。
对云服务器来说,系统失联并不总意味着磁盘上的系统已经彻底报废。先保留现场、检查启动链,再决定是否重装,往往能避免把一个本来可以修复的问题变成不可逆的数据损失。
这次也提醒了我:以后尝试不同 Debian 版本的 DD 安装方式之前,应该先核实镜像来源、脚本具体行为和启动兼容性,并尽量在可恢复的测试环境中验证。